Para criar um podcast em vídeo com IA para duas pessoas, combine uma imagem com os dois apresentadores e o áudio atribuído aos personagens da esquerda e da direita. Associe cada voz ao respectivo rosto e preserve as pausas entre as falas.
No LipSync Studio, você pode enviar faixas separadas para cada locutor, dividir uma conversa já existente ou gerar o áudio do podcast e depois dividi-lo. Qualquer um desses caminhos prepara o áudio para dois papéis. Cenas com três ou mais falantes independentes estão fora deste fluxo de trabalho, e o resultado é um vídeo renderizado, não um agente de conversação ao vivo.
O que preparar
- Uma imagem compartilhada: dois rostos visíveis com as bocas desobstruídas.
- Áudio: faixas finalizadas por personagem, uma conversa já mixada ou um texto-base para um novo roteiro.
- A posição de cada personagem: anote quem fica à esquerda e à direita na imagem. O nome de uma voz ou um rótulo como “Locutor A” não define automaticamente a posição dessa pessoa na tela.
Você precisa de áudio para pelo menos um dos personagens. É possível fornecer apenas uma faixa e deixar a outra vazia para criar uma cena de locutor e ouvinte; nesse caso, inspecione o comportamento do ouvinte no vídeo gerado.
Um locutor e um ouvinte
Exemplo existente do site LipSync Studio: um personagem fala enquanto o outro escuta. Ele ilustra o tipo de cena, separado do teste cronometrado de prática mostrado mais abaixo.
Abrir o exemplo de locutor e ouvinte em MP4
Para um único apresentador na tela, use o tutorial para fazer uma foto falar. Para localizar gravações de vídeo já existentes para outros idiomas, consulte a tradução de vídeo com IA.
Etapa 1: Escolha uma imagem com duas pessoas
Abra o gerador de vídeo de podcast com IA, que utiliza o modelo Imagem de sincronização labial (dois locutores). Envie uma imagem, gere uma cena ou escolha um exemplo pronto.
Para um primeiro teste, escolha uma composição simples de entrevista com espaço entre os rostos. Posicione os microfones ao lado ou abaixo das bocas, e não na frente delas. Dê zoom para inspecionar lábios, dentes, óculos e o contorno dos rostos.
Evite rostos minúsculos e fotos de grupo lotadas. Se quiser testar apresentadores ilustrados, animais ou outros personagens estilizados, avalie um clipe curto antes de planejar um episódio longo com eles.
Etapa 2: Escolha a opção de áudio que combina com seu material
A seção de escolha do fluxo de entrada de áudio oferece três rotas:
| Rota | Quando usar | Antes de gerar o vídeo |
|---|---|---|
| Duas faixas separadas | A gravação de cada pessoa já existe separadamente | Envie os arquivos da esquerda e da direita; escolha a ordem de reprodução |
| Dividir um podcast | As duas vozes estão em uma única gravação finalizada | Divida o áudio, ouça os dois resultados e confirme a atribuição de vozes |
| Gerar áudio de podcast | Você tem um artigo, documento ou roteiro novo | Revise o roteiro e o áudio gerado; depois divida nas faixas de cada papel |
Rota A: Duas faixas separadas
Selecione Duas faixas separadas. Coloque a voz da pessoa da esquerda no campo da esquerda e a voz da pessoa da direita no campo da direita. Reproduza cada arquivo isoladamente para confirmar a atribuição.
Para um diálogo com alternância de turnos, cada faixa deve conter apenas as falas do respectivo locutor, mantendo silêncio enquanto a outra pessoa fala. Ambos os arquivos devem preservar suas posições na mesma linha do tempo.
Se o convidado começa a falar no segundo 5, o arquivo do convidado precisa ter cinco segundos de silêncio inicial. Remover esse silêncio puxa a resposta para o segundo zero. Exportar apenas as palavras de cada pessoa sem as pausas destrói o tempo da conversa.
Rota B: Dividir um podcast
Escolha Dividir um podcast, envie a gravação e clique para dividir o áudio (Separar podcast). O fluxo de trabalho prepara faixas de mesma duração para cada personagem, silenciando os turnos do outro locutor, e seleciona automaticamente a ordem de reprodução meanwhile.
Ouça cada faixa resultante, prestando atenção especial ao início, às trocas de turno e às falas sobrepostas. Verifique se há palavras cortadas, vazamento de voz de um canal para o outro ou avisos de separação.
Se a divisão estiver limpa, mas os apresentadores estiverem invertidos, use a opção para inverter os locutores (Swap speakers). Se as duas vozes continuarem presentes na mesma faixa ou se faltar alguma frase, corrija ou substitua o áudio primeiro. A inversão apenas troca a atribuição de lado, não o conteúdo dentro da faixa.
Rota C: Gerar áudio de podcast
Escolha Gerar áudio de podcast e cole um texto ou adicione um arquivo de origem. Os formatos PDF, DOCX, TXT e Markdown são compatíveis. Revise a transcrição antes de gerar as vozes: confira fatos, nomes e números, decida quem pergunta e quem responde e mantenha os turnos de fala equilibrados.
Ouça a conversa gerada do início ao fim. Uma entonação natural não garante precisão factual; a síntese pode adicionar ou alterar algum detalhe. Corrija o roteiro ou o áudio e, em seguida, divida-o nas faixas da esquerda e da direita antes de criar o vídeo. A geração de áudio, a divisão de faixas e a geração de vídeo são operações separadas; portanto, verifique os créditos em cada etapa.
Etapa 3: Escolha a ordem de reprodução
A opção de faixas separadas oferece três valores de ordem. Eles posicionam arquivos de áudio inteiros na linha do tempo:
| Ordem | O que acontece | Para que usar |
|---|---|---|
meanwhile | Os dois arquivos começam juntos | Faixas alinhadas na linha do tempo, com silêncio entre os turnos |
left_right | O arquivo esquerdo inteiro toca primeiro; depois toca o direito | Uma fala completa da esquerda seguida por uma fala completa da direita |
right_left | O arquivo direito inteiro toca primeiro; depois toca o esquerdo | Uma fala completa da direita seguida por uma fala completa da esquerda |
Para um diálogo dinâmico de perguntas e respostas, use faixas alinhadas com meanwhile. Os dois arquivos rodam juntos; os intervalos de silêncio criam a alternância de turnos. Nessa linha do tempo compartilhada, falas simultâneas acontecem quando há voz ocupando o mesmo instante nos dois arquivos.
As ordens sequenciais (left_right e right_left) não intercalam frases automaticamente. Duas faixas alinhadas de 20 segundos reproduzidas em left_right formam uma linha do tempo planejada de 40 segundos. O mesmo par reproduzido em meanwhile compartilha uma linha do tempo de áudio de 20 segundos. As rotas que dividem o áudio selecionam meanwhile por padrão para seus arquivos alinhados.
Veja um vídeo de conversa entre duas pessoas
Este exemplo existente do site mostra dois personagens se revezando em uma cena compartilhada:
Exemplo existente do LipSync Studio com dois locutores. Ele é separado do exemplo curto gravado e do exercício ilustrativo de 20 segundos mostrados abaixo.
Abrir o exemplo de dois locutores em MP4
Baixe e inspecione o teste curto de prática
Usamos uma imagem sintética com dois personagens e estas falas em inglês para um teste curto:
Esquerda: Can one picture hold a conversation? Let us try it with two voices.
(Significado em português: “Uma única imagem pode sustentar uma conversa? Vamos tentar com duas vozes.”)
Direita: Yes. Keep both voices on the same timeline, and leave the silence in place.
(Significado em português: “Sim. Mantenha as duas vozes na mesma linha do tempo e deixe o silêncio no lugar.”)
Ambos os arquivos de entrada têm duração total de 12,500 segundos. Baixe o par para ouvir separadamente e compará-los com o vídeo gerado:
Imagem original · WAV da esquerda · WAV da direita · MP4 gerado
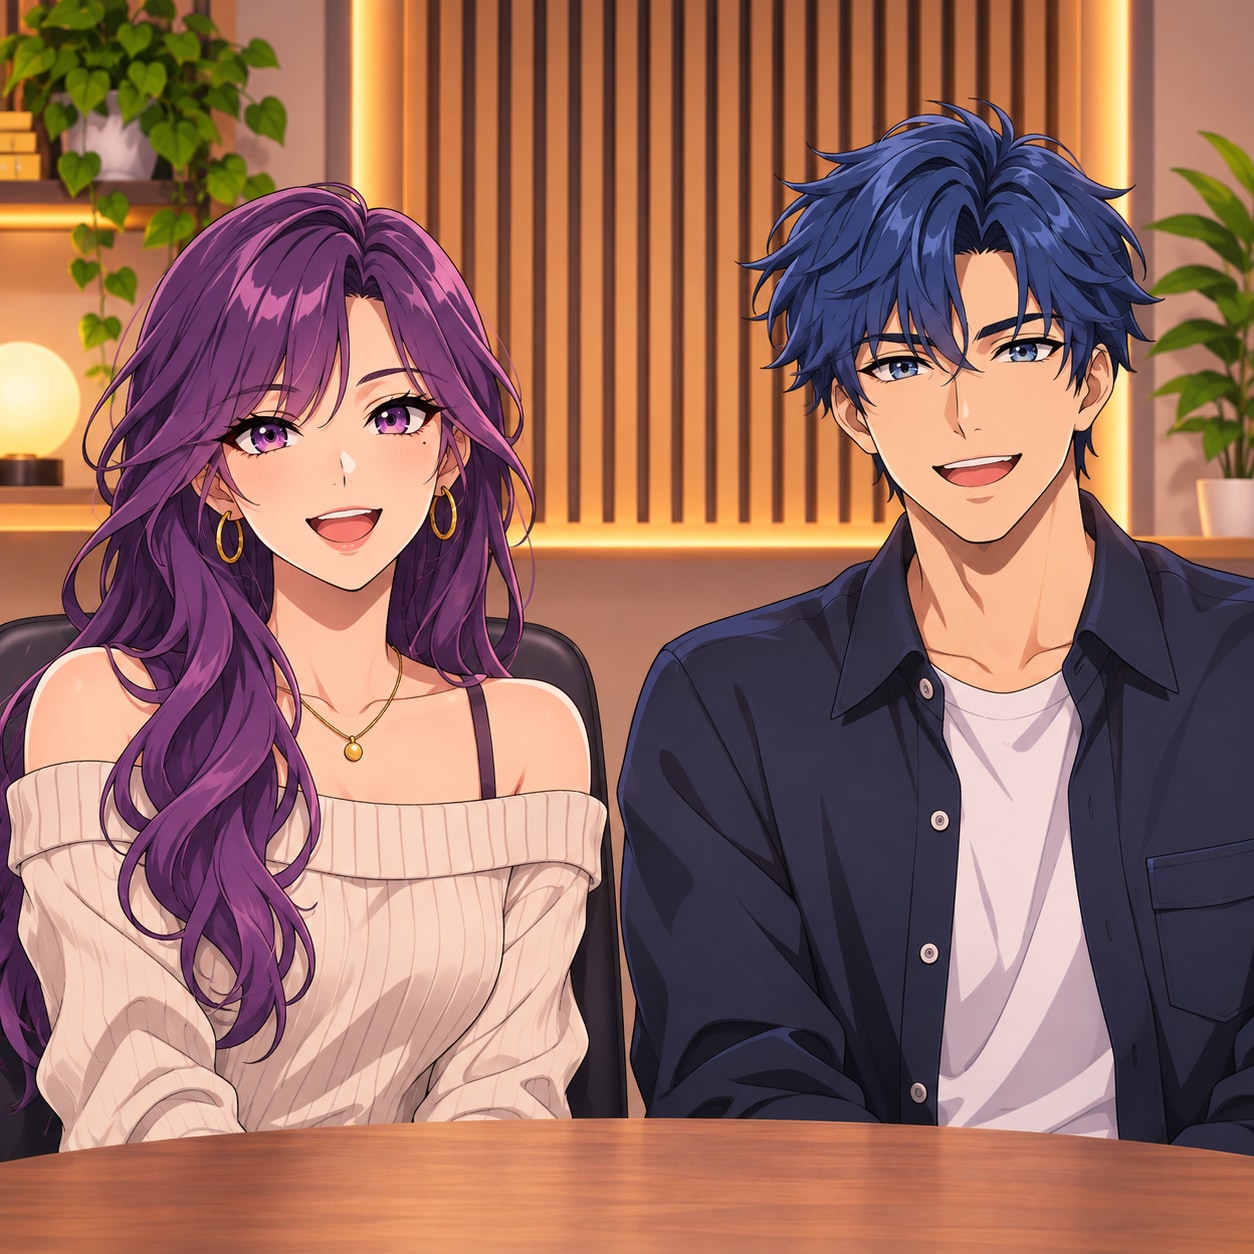
| Gravação de entrada | Posicionamento na linha do tempo compartilhada |
|---|---|
| Gravação da esquerda | Posicionada em 0,000 segundos; o arquivo termina em 6,240 segundos |
| Gravação da direita | Posicionada em 6,800 segundos; o arquivo termina em 11,969 segundos (arredondado para milissegundos) |
Estes valores representam os limites de cada gravação inserida (incluindo qualquer silêncio contido nela), e não marcações de tempo palavra por palavra.
Detalhes da amostra: 5 de nov. de 2026 · meanwhile · saída de 13,500 segundos · 480 × 480 pixels.
A duração do vídeo retornado (13,500 segundos) difere da linha do tempo de entrada de 12,500 segundos; portanto, sempre verifique o arquivo exportado antes de sincronizar legendas ou fazer novos cortes. Este exemplo utiliza faixas preparadas separadamente; ele não avalia a precisão da separação automática de áudio nem da geração de roteiro.
Prática: monte uma conversa de 20 segundos
Este exercício separado fornece metas de edição para gravação, e não tempos medidos de um modelo de vídeo. Grave com naturalidade e ajuste os intervalos ou o texto se precisar. Alex está à esquerda; Jamie está à direita.
| Tempo | Faixa da esquerda: Alex | Faixa da direita: Jamie |
|---|---|---|
| 0:00–0:04 | “O que faz um corte de podcast ser bom?” | Silêncio |
| 0:04–0:05 | Silêncio | Silêncio |
| 0:05–0:09 | Silêncio | “Uma pergunta clara e uma resposta que valha a pena ouvir.” |
| 0:09–0:10 | Silêncio | Silêncio |
| 0:10–0:14 | “Então a gente deixa só a parte útil?” | Silêncio |
| 0:14–0:15 | Silêncio | Silêncio |
| 0:15–0:19 | Silêncio | “Exatamente. Dê às pessoas um motivo para continuar ouvindo.” |
| 0:19–0:20 | Silêncio | Silêncio |
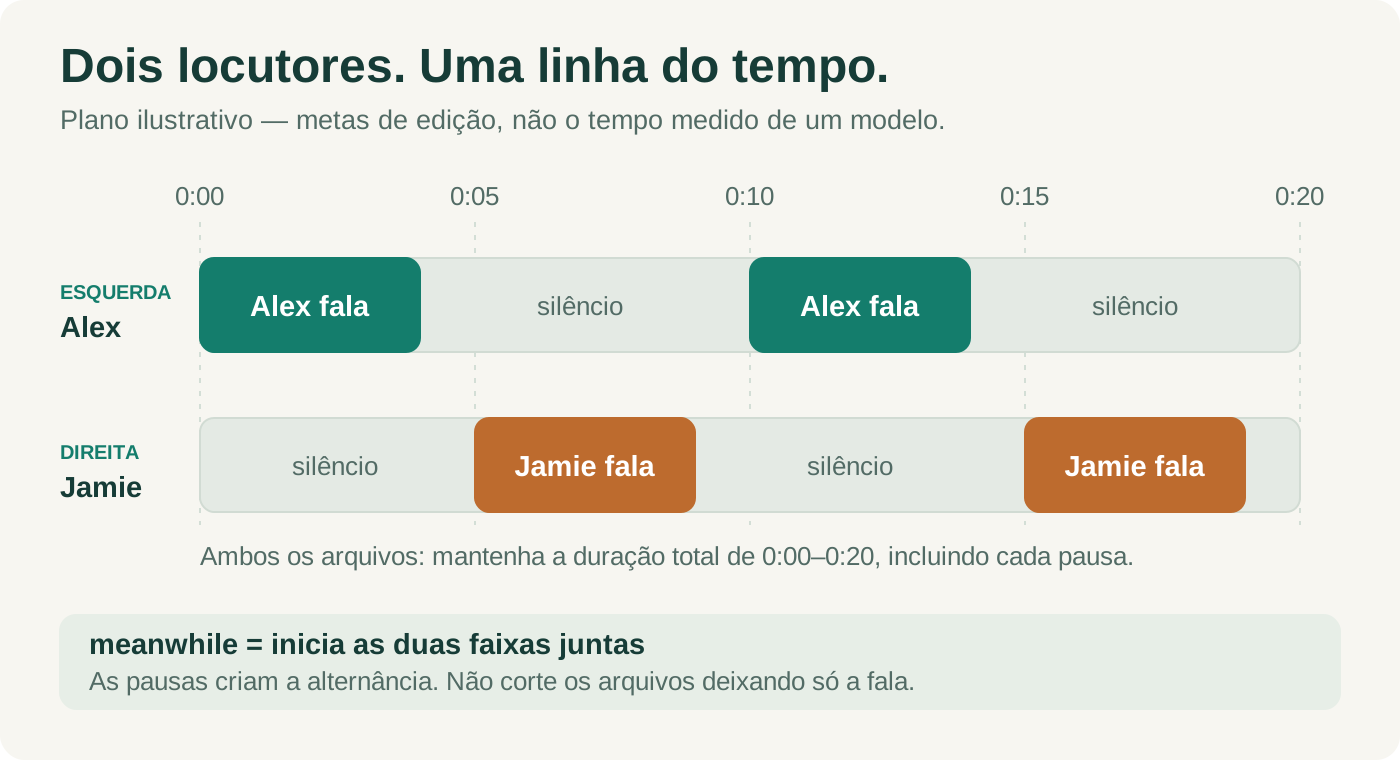
Plano de gravação ilustrativo. Exporte ambas as faixas de 0:00 a 0:20 e use meanwhile para que os intervalos de silêncio preservem os turnos de fala.
Em um editor de áudio:
- Crie duas faixas no mesmo projeto e posicione cada fala na faixa do respectivo personagem.
- Exporte apenas a faixa de Alex cobrindo todo o intervalo de 0:00 a 0:20, incluindo o silêncio.
- Exporte apenas a faixa de Jamie cobrindo exatamente o mesmo intervalo. Não apare nenhum dos arquivos na primeira ou na última palavra.
- Ouça o par junto e depois cada arquivo isoladamente. Cada arquivo deve conter apenas as falas do seu personagem.
- Envie Alex como esquerda e Jamie como direita; selecione
meanwhile.
Etapa 4: Verifique as configurações e gere um vídeo curto
Confirme o atribuição das vozes após qualquer alteração no áudio. Um prompt de texto não consegue corrigir uma voz anexada ao rosto errado. Para uma conversa calma, descreva o comportamento visível:
Dois apresentadores têm uma conversa descontraída. Use expressões faciais
suaves e movimentos pequenos e naturais. Mantenha as mãos quase paradas.
Escolha uma Resolução disponível e confira a estimativa de créditos. A verificação atual de duração para usuários conectados é de 500 segundos de áudio efetivo: a faixa mais longa ao usar meanwhile, ou a soma das duas faixas na reprodução sequencial. Dois arquivos alinhados de 60 segundos contam, portanto, como 60 segundos em meanwhile, e não 120. Esse cálculo não garante a duração exata do arquivo de vídeo retornado, como mostra o exemplo acima. Confirme os limites atuais e as opções da sua conta diretamente no formulário.
Gere um trecho curto primeiro. Salve a imagem, os arquivos de cada papel, a ordem, o prompt, a resolução e as configurações para poder reproduzir a mesma estrutura depois.
Etapa 5: Revise quem fala e quem escuta
Assista ao teste completo uma vez focando no personagem da esquerda e depois outra vez focando no da direita. Em cada troca de turno, verifique a atribuição da voz, o início e o fim do movimento da boca, o comportamento de quem está ouvindo e a estabilidade de dentes, óculos e microfones. Preste atenção se as pausas intencionais foram mantidas e se alguma palavra se perdeu.
Para vídeos mais longos, repita essas verificações nas trocas de falante ao longo de todo o clipe. O fato de a primeira interação estar correta não garante que a última também esteja.
Solução de problemas
| Sintoma | O que inspecionar | Próximo passo |
|---|---|---|
| A voz da direita sai do rosto da esquerda | Atribuição de papéis | Inverta os locutores (Swap speakers) ou corrija os campos enviados |
| Os dois apresentadores parecem falar o tempo todo | Conteúdo e ponto de início de cada faixa | Ouça separadamente; corrija a divisão ou use gravações limpas e alinhadas |
| As respostas começam cedo demais | Silêncio inicial | Exporte novamente ambas as faixas a partir do mesmo ponto zero |
| Pausas longas demais entre os turnos | Reprodução sequencial de arquivos já alinhados | Selecione a ordem meanwhile |
| Palavras somem após dividir o áudio | Resultado da divisão e falas sobrepostas | Compare com o original; repare o áudio antes de renderizar o vídeo |
| Detalhes do rosto ou da boca falham | Obstruções na imagem, nível de detalhe e movimento | Teste uma imagem mais nítida e uma atuação curta mais contida |
Utilize vozes e imagens de pessoas para as quais você tenha permissão e informe quando os clipes forem sintéticos, caso o público possa confundi-los com gravações reais. Monte um diálogo curto no gerador de vídeo de podcast com IA antes de expandir para um episódio mais longo.