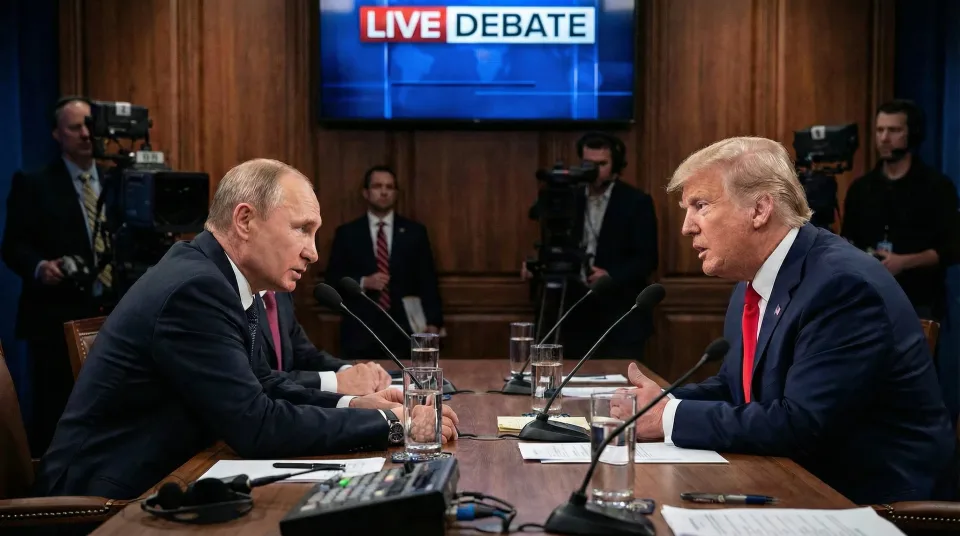

双人说话
生成双人对话或播客视频
用一张双人图片生成自然的播客或对话视频。可以分别上传两位说话者的音频,也可以先把完整播客音频拆成不同角色轨道。
使用模型口型同步图像(两位说话者)
操作步骤
- 1上传双人图片。
- 2分别上传两条说话者音频。
- 3生成双人口型同步视频。
建议
如果使用音频分离,请先预听拆分结果。每条音轨应只包含对应角色的声音,同时保持原始时间轴。
AI 播客视频生成器根据双人图片和说话者音频生成对话场景。独立音轨有助于将每个声音对应到正确的人物。 每位说话者使用独立音轨,并保留原始时间轴。生成前试听分离音轨,确认人物与声音的对应关系。
图像口型同步(两位说话者):推荐——非常适合播客与对话场景;支持两位说话者。
*1. 上传照片或生成/编辑图像
选择上传两条已分好的角色音轨、分离一个已有播客,或先生成播客音频。
至少上传一个音频。如果左侧角色未上传音频,该角色将保持沉默。
至少上传一个音频。如果右侧角色未上传音频,该角色将保持沉默。
输出视频中两个音源的顺序。'meanwhile' 表示两个音源将同时播放,'left_right' 表示左侧音频将首先播放,然后播放右侧音频,'right_left' 表示右侧音频将首先播放,然后播放左侧音频。
登录可领取每日免费点数,开始生成视频。关闭页面后任务仍会继续,请勿重复提交同一任务。历史结果可在“我的创作”中查看。
用一张双人图片生成自然的播客或对话视频。可以分别上传两位说话者的音频,也可以先把完整播客音频拆成不同角色轨道。
操作步骤
如果使用音频分离,请先预听拆分结果。每条音轨应只包含对应角色的声音,同时保持原始时间轴。
当图片或视频中有多个人物,但只希望其中一个角色说话时,用说话人控制功能精确指定嘴型同步区域。
操作步骤
请在图片或视频上传成功后再创建遮罩。用白色覆盖说话角色的嘴唇、脸部、身体以及其它需要控制的区域。
生成一个人说话、另一个人安静倾听的双人画面,适合访谈、反应视频、教学片段和播客场景。
操作步骤
只提供一条说话音频时,选中的角色会开口说话,另一位角色保持静默,形成自然的倾听效果。
日语
西班牙语
源视频
把一个源视频本地化成带翻译配音和口型同步的新版本,适合课程、产品演示、广告、教程和社媒内容出海。
操作步骤
快速模式适合先出草稿;更重视质量时选择高级模式。
参考图片
@audio1
提示词
Use the song from @audio1 to generate a video of a man singing.
通过参考图片、参考音频和提示词生成新视频。适合需要控制镜头运动、画面风格、表情、动作或叙事的场景。
操作步骤
当你不只是要基础口型同步,而是需要电影感构图、镜头运动或风格化画面时,优先使用这个流程。
提示词
A panda sits on the left and looks at the camera, saying, "Hello everyone." After that, a raccoon on the right speaks and says, "Welcome to Lip Sync Studio"
直接用文本提示词生成说话或对话视频。在提示词里写清角色要说的台词,同时描述场景、表情、节奏和镜头。
操作步骤
把台词直接写进提示词中,模型才能为每个角色生成同步语音和嘴型动作。
参考图片


提示词
A cinematic, ultra-realistic SaaS video ad with native synchronized high-quality voiceover. At the opening frame, the bold white text "lipsync.studio" dynamically drops from the top, settling in the center with a soft organic bounce and a subtle glowing neon orange light, before scaling down to the bottom watermark. The camera dynamically zooms into @image1. The cat stands on stage holding the microphone, its whiskers twitching naturally and fur swaying as it speaks like a stand-up comedian, enthusiastically saying: "Why sing when you can just talk?". With a smooth slide-transition, it cuts to @image2. The cool gorilla leans its arm comfortably on the car window, blinking naturally and nodding its head as it talks in a deep, humorous voice: "Exactly, buddy. Just let AI do the talking." A fluid warp transition pans to @image3. The baby closed-eyes, swaying gently, holding the microphone with a natural grip, babbling happily with a sweet baby voice: "Try it for free now!". Photorealistic, 60fps fluid motion.
用多张参考图片和详细提示词生成短视频广告。适合每个镜头都需要清晰角色、旁白和转场的品牌内容。
操作步骤
让每个参考标签对应一个镜头,有助于模型保持角色身份和镜头顺序。
上传已有视频和新的音频,生成口型同步版本。当视频中只有一个人需要说话时,也可以添加说话人遮罩。
操作步骤
Lip Sync Video 会结合整体视频上下文;Only Lip Region 只聚焦嘴唇区域,并且原视频中的嘴唇必须清晰可见且有可检测动作。
上传一张人像和一段音频,即可生成唱歌、演讲或讲解类视频。适合数字人、虚拟主持、课程讲解、音乐头像和社媒短视频。
操作步骤
如果图片里有文字,或需要更强的头部动作、表情控制,建议选择可控表情与动作的图片模型。
AI 播客视频生成器根据双人图片和说话者音频生成对话场景。独立音轨有助于将每个声音对应到正确的人物。 每位说话者使用独立音轨,并保留原始时间轴。生成前试听分离音轨,确认人物与声音的对应关系。
一张包含两个人的图片,以及分别对应两位说话者、时间对齐的音轨。
每位说话者使用独立音轨,并保留原始时间轴。生成前试听分离音轨,确认人物与声音的对应关系。
可用模型、文件格式、时长、分辨率、积分和付费选项因流程而异。提交前请查看所选模型和生成器显示的费用。生成质量取决于原始素材,使用前请预览结果。
用双人图片和独立音轨创建对话场景,将声音分配给对应人物,制作播客、访谈和一人说话一人聆听的视频。
以原始人物、动物或角色的面部与参考细节为基础,保持角色在表演中的辨识度,让观众关注熟悉的形象和内容。
通过音频与表演提示词引导面部表情和动作,让角色传达更贴合台词的情绪。先预览短片,检查表情、嘴部与整体表达。
上传或录制音频,也可以使用文字转语音、声音克隆、音乐和图片生成工具准备素材。先试听和检查,再创建表演视频。
利用说话、旁白或演唱音轨驱动角色。清晰的人声和可见的嘴部有助于制作问候、讲解和歌曲表演。
图片生成、录音、文字转语音、声音与音乐工具、视频动画集中使用,从准备素材到查看成片,在一个工作区完成创作。
标准版
* 年订阅额度一次性发放,按年周期刷新(每12个月)。
安全支付
可用支付方式因设备和地区而异。
专业版
* 年订阅额度一次性发放,按年周期刷新(每12个月)。
安全支付
可用支付方式因设备和地区而异。
基础版
* 年订阅额度一次性发放,按年周期刷新(每12个月)。
安全支付
可用支付方式因设备和地区而异。
按需付费,点数永久不过期。
安全支付
可用支付方式因设备和地区而异。
上传音频和说话者图片,调整时长和质量等设置,即可立即生成专业的多人唇形同步播客视频。
我们的AI播客视频生成器使用先进技术对齐音素和面部动作,为专业播客视觉效果创建引人注目的多人唇形同步。
将您的播客音频(MP3/WAV)和说话者图片(PNG/JPG)添加到AI播客视频生成器中。
配置时长、质量和多人唇形同步偏好设置。
创建具有同步多人唇形同步的专业播客视频。
查看您的AI生成播客视频,立即下载或分享。