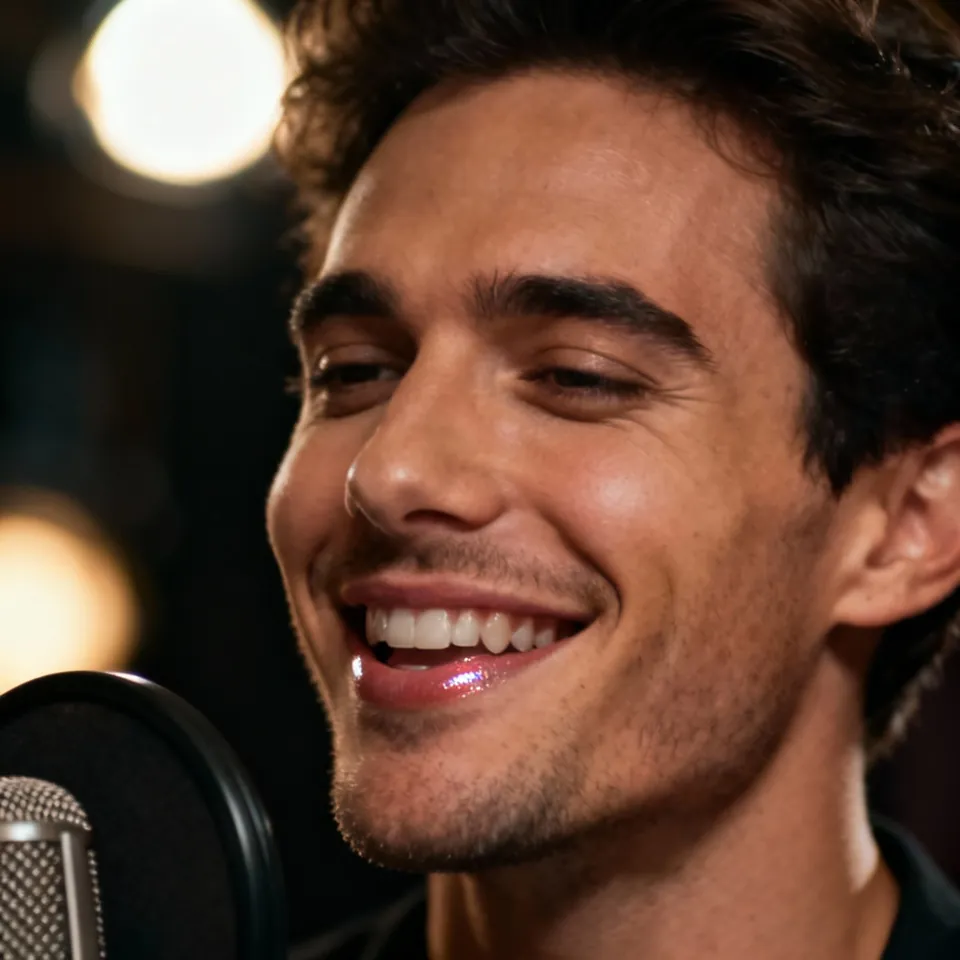

圖片對嘴
用一張圖片生成唱歌或演講影片
上傳一張人像和一段音訊,即可生成唱歌、演講或講解影片。適合虛擬人物、主持人、課程講解、音樂演出和社群短片。
使用模型口型同步圖像(最長10分鐘,可控說話者)口型同步圖像(最長5分鐘,可控表情與動作)
操作步驟
- 1上傳清晰的人像圖片。
- 2上傳演講、旁白或唱歌音訊。
- 3生成對嘴影片。
建議
如果圖片中有文字,或需要更細緻的頭部動作與表情控制,建議選擇可控制表情和動作的照片動畫功能。
LipSync Studio 將圖片與音軌結合成說話或唱歌影片。圖片提供角色和構圖,音訊提供語言或演唱內容。 使用光線充足、無遮擋的人臉和清晰音訊。先產生短片,檢查嘴部動作後再製作長影片。
表現力更強的 AI 虛擬人影片生成器(AI avatar video generator),對人像控制更好,也能更多保留原圖中的文字和細節;可透過提示詞控制情緒、表情強度和動作風格,適合演講、產品展示等表現型場景。
*1. 上傳照片或生成/編輯圖像
*2. 上傳音訊或生成音訊
登入可領取每日免費點數,開始製作影片。關閉頁面後任務仍會繼續,請勿重複提交相同任務。過往作品可在「我的創作」中查看。
上傳一張人像和一段音訊,即可生成唱歌、演講或講解影片。適合虛擬人物、主持人、課程講解、音樂演出和社群短片。
操作步驟
如果圖片中有文字,或需要更細緻的頭部動作與表情控制,建議選擇可控制表情和動作的照片動畫功能。
用一張雙人圖片生成自然的 Podcast 或對話影片。可分別上傳兩位說話者的音訊,也可以先將完整的 Podcast 音訊拆分為不同角色的音軌。
操作步驟
使用音訊分離功能後,請先試聽拆分結果。每條音軌應只包含對應角色的聲音,並維持原始時間軸。
當圖片或影片中有多位人物,但只希望其中一位說話時,可使用說話者控制功能,指定需要同步嘴型的區域。
操作步驟
請在圖片或影片上傳成功後再建立遮罩。用白色覆蓋說話角色的嘴唇、臉部、身體及其他需要控制的區域。
生成一人說話、另一人安靜聆聽的雙人畫面,適合訪談、反應影片、教學片段和 Podcast 場景。
操作步驟
只提供一條語音音軌時,選取的角色會開口說話,另一位角色則保持安靜,呈現自然的聆聽效果。
日文
西班牙文
原始影片
將原始影片轉換為帶有翻譯配音和同步嘴型的版本,適合課程、產品展示、廣告、教學和社群內容的跨語言製作。
操作步驟
快速模式適合先製作草稿;若更重視品質,請選擇進階模式。
參考圖片
@audio1
提示詞
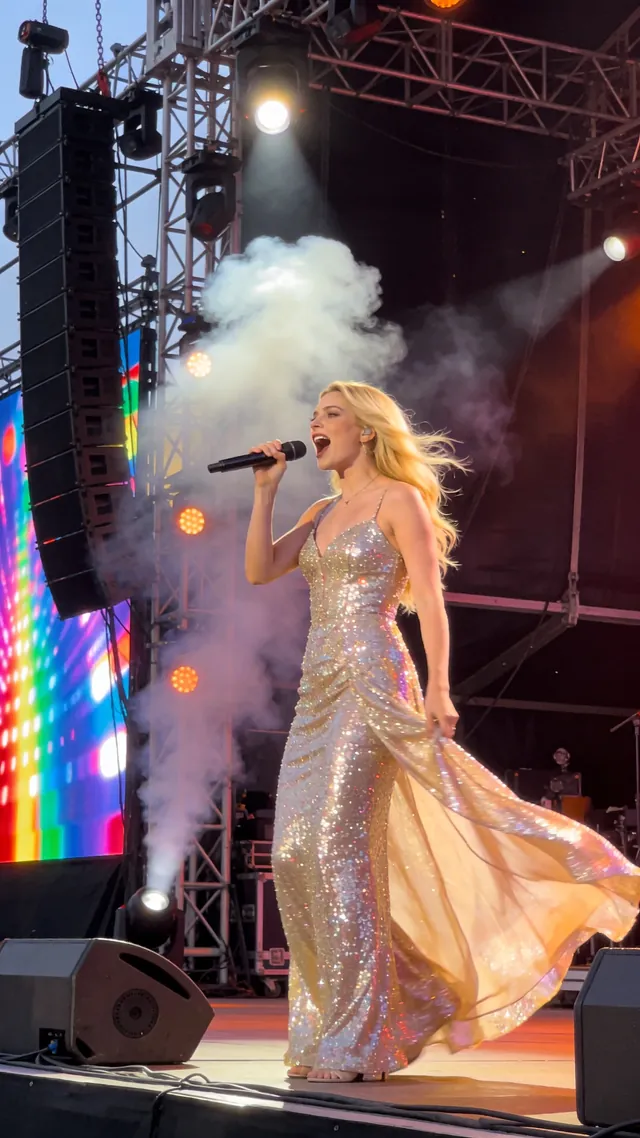
Use the song from @audio1 to generate a video of a man singing.
結合參考圖片、參考音訊和提示詞生成新影片,適合需要控制鏡頭運動、畫面風格、表情、動作或敘事的場景。
操作步驟
需要電影感構圖、鏡頭運動或風格化畫面時,可優先選擇此流程。
提示詞
A panda sits on the left and looks at the camera, saying, "Hello everyone." After that, a raccoon on the right speaks and says, "Welcome to Lip Sync Studio"
直接用文字提示詞生成說話或對話影片。在提示詞中寫清楚角色的台詞,並描述場景、表情、節奏和鏡頭。
操作步驟
將完整台詞寫入提示詞,讓 AI 為各角色生成同步的語音和嘴型動作。
參考圖片


提示詞
A cinematic, ultra-realistic SaaS video ad with native synchronized high-quality voiceover. At the opening frame, the bold white text "lipsync.studio" dynamically drops from the top, settling in the center with a soft organic bounce and a subtle glowing neon orange light, before scaling down to the bottom watermark. The camera dynamically zooms into @image1. The cat stands on stage holding the microphone, its whiskers twitching naturally and fur swaying as it speaks like a stand-up comedian, enthusiastically saying: "Why sing when you can just talk?". With a smooth slide-transition, it cuts to @image2. The cool gorilla leans its arm comfortably on the car window, blinking naturally and nodding its head as it talks in a deep, humorous voice: "Exactly, buddy. Just let AI do the talking." A fluid warp transition pans to @image3. The baby closed-eyes, swaying gently, holding the microphone with a natural grip, babbling happily with a sweet baby voice: "Try it for free now!". Photorealistic, 60fps fluid motion.
結合多張參考圖片和詳細提示詞生成短片廣告,適合各鏡頭都需要明確角色、旁白和轉場的品牌內容。
操作步驟
讓每個參考標籤對應一個鏡頭,有助於保持角色外觀與鏡頭順序一致。
上傳既有影片和新音訊,生成對嘴版本。當影片中只有一人需要說話時,也可以加入說話者遮罩。
操作步驟
影片對嘴會參考整體畫面;僅調整嘴部的功能則專注於嘴唇區域,原始影片中的嘴唇須清晰可見,並有可偵測的動作。
LipSync Studio 將圖片與音軌結合成說話或唱歌影片。圖片提供角色和構圖,音訊提供語言或演唱內容。 使用光線充足、無遮擋的人臉和清晰音訊。先產生短片,檢查嘴部動作後再製作長影片。
一張清晰圖片,以及一段說話、旁白或演唱音訊。
使用光線充足、無遮擋的人臉和清晰音訊。先產生短片,檢查嘴部動作後再製作長影片。
可用模型、檔案格式、時長、解析度、點數及付費選項因流程而異。提交前請查看所選模型及產生器顯示的費用。產生品質取決於原始素材,使用前請預覽結果。
支援的模型提供不同解析度選項,部分流程可選擇最高 4K 輸出。請查看目前模型的選項、時長與點數費用。
從真人照片到動漫角色、插畫人物與動物形象,為不同角色加入說話或唱歌表演,依素材選擇合適模型。
透過音訊與表演提示詞引導面部表情和動作,讓角色傳達更貼合臺詞的情緒。先預覽短片,檢查表情、嘴部與整體表達。
以原始人物、動物或角色的面部與參考細節為基礎,保持表演中的角色辨識度,延續觀眾熟悉的形象。
上傳或錄製音訊,也可以使用文字轉語音、聲音複製、音樂與圖片產生工具準備素材。先試聽和檢查,再建立表演影片。
圖片產生、錄音、文字轉語音、聲音與音樂工具、影片動畫集中使用,從準備素材到檢查成片,在同一工作區完成。
標準版
* 年訂閱額度一次性發放,按年週期刷新(每12個月)。
安全付款
可用付款方式因裝置和地區而異。
企業方案
* 年訂閱額度一次性發放,按年週期刷新(每12個月)。
安全付款
可用付款方式因裝置和地區而異。
基本方案
* 年訂閱額度一次性發放,按年週期刷新(每12個月)。
安全付款
可用付款方式因裝置和地區而異。
按需付費,點數永久不過期。
安全付款
可用付款方式因裝置和地區而異。
使用我們先進的音訊轉影片 AI 釋放音訊檔的全部潛力。學習如何從音訊生成影片、建立無縫的含音訊影像轉影片同步,並在幾次點擊中套用專業 AI 影片配音。
我們的音訊轉影片 AI 引擎採用新一代深度學習連結聲音與影像。它精準對齊音素與視覺動態,使從音訊生成影片自然真實。體驗最佳的含音訊影像轉影片技術。
匯入你的音軌(WAV、MP3),開始音訊轉影片流程。
選擇參考影像或頭像進行含音訊影像轉影片轉換。
我們的音訊轉影片 AI 引擎整合輸入以從音訊生成影片。
預覽你驚豔的含音訊影像轉影片作品,並以高畫質下載。